数据压缩,数据压缩
(一)数据压缩的概念
数据压缩是指在不丢失或尽可能少丢失数据信息的前提下,通过特定的算法和技术,对原始数据进行重新编码和处理,以减少数据存储空间或传输带宽的过程。其目的是提高数据存储、传输和处理的效率,同时保证数据的可用性和一定的质量要求。
数据压缩可以分为有损压缩和无损压缩两类。无损压缩能够确保解压后的数据与原始数据完全一致,常用于对数据准确性要求较高的场景,如文本、程序代码等;有损压缩则会在一定程度上牺牲数据的精度来换取更高的压缩比,适用于对数据质量损失有一定容忍度的场景,如图像、音频、视频等多媒体数据。
(二)数据压缩的优缺点
压缩的好处和坏处
压缩的优点:以减少磁盘IO、减少磁盘存储空间。
压缩的缺点:增加CPU开销。
压缩原则
(1)运算密集型的Job,少用压缩
(2)IO密集型的Job,多用压缩
(三)MR支持的压缩编码
MapReduce支持很多的压缩的算法,下面我们分别介绍一下:
1.压缩算法对比介绍
|
压缩格式 |
Hadoop自带? |
算法 |
文件扩展名 |
是否可切片 |
换成压缩格式后,原来的程序是否需要修改 |
|
DEFLATE |
是,直接使用 |
DEFLATE |
.deflate |
否 |
和文本处理一样,不需要修改 |
|
Gzip |
是,直接使用 |
DEFLATE |
.gz |
否 |
和文本处理一样,不需要修改 |
|
bzip2 |
是,直接使用 |
bzip2 |
.bz2 |
是 |
和文本处理一样,不需要修改 |
|
LZO |
否,需要安装 |
LZO |
.lzo |
是 |
需要建索引,还需要指定输入格式 |
|
Snappy |
是,直接使用 |
Snappy |
.snappy |
否 |
和文本处理一样,不需要修改 |
2.压缩性能的比较
|
压缩算法 |
原始文件大小 |
压缩文件大小 |
压缩速度 |
解压速度 |
|
gzip |
8.3GB |
1.8GB |
17.5MB/s |
58MB/s |
|
bzip2 |
8.3GB |
1.1GB |
2.4MB/s |
9.5MB/s |
|
LZO |
8.3GB |
2.9GB |
49.3MB/s |
74.6MB/s |
|
Snappy |
8.3GB |
6GB |
250MB/s |
500MB/s |
(四)压缩方式选择
压缩方式选择时重点考虑:压缩/解压缩速度、压缩率(压缩后存储大小)、压缩后是否可以支持切片。
Gzip压缩
优点:压缩率比较高;
缺点:不支持切片;压缩/解压速度一般;
Bzip2压缩
优点:压缩率高;支持切片;
缺点:压缩/解压速度慢。
Lzo压缩
优点:压缩/解压速度比较快;支持切片;
缺点:压缩率一般;想支持切片需要额外创建索引。
Snappy压缩
优点:压缩和解压缩速度快;
缺点:不支持切片;压缩率一般;
(五)压缩位置选择
在MR框架下,有三个位置可以对数据进行压缩。
- 输入给map之前。hadoop自动检查文件拓展名,如果拓展名能够匹配,就会用恰当的编解码方式对文件进行压缩和解压。 如果数据量小于块大小(128M),则不需要考虑切点问题,重点考虑压缩和解压缩速度比较快的LZO/Snappy。如果需要切片,重点考虑支持切片的Bzip2和LZO。
- Mapper输出。为了减少MapTask和ReduceTask之间的网络IO,重点考虑压缩和解压缩快的LZO,Snappy。
- Reducer输出端。如果数据需要永久保存,考虑压缩比比较高的Bzip2和Gzip。如果数据要作为下一个MapReduce的输入,需要考虑数据量和是否支持切片。
(六)压缩参数配置
1.为了支持多种压缩/解压缩算法,Hadoop引入了编码/解码器。具体的明细如下。
|
压缩格式 |
对应的编码/解码器 |
|
DEFLATE |
org.apache.hadoop.io.compress.DefaultCodec |
|
gzip |
org.apache.hadoop.io.compress.GzipCodec |
|
bzip2 |
org.apache.hadoop.io.compress.BZip2Codec |
|
LZO |
com.hadoop.compression.lzo.LzopCodec |
|
Snappy |
org.apache.hadoop.io.compress.SnappyCodec |
2.要在Hadoop中启用压缩,可以配置如下参数。 根据我们之前的分析,有三个阶段可以开启压缩,分别如下:
|
参数 |
默认值 |
阶段 |
建议 |
|
io.compression.codecs (在core-site.xml中配置) |
无,这个需要在命令行输入hadoop checknative查看 |
输入压缩 |
Hadoop使用文件扩展名判断是否支持某种编解码器 |
|
mapreduce.map.output.compress(在mapred-site.xml中配置) |
false |
mapper输出 |
这个参数设为true启用压缩 |
|
mapreduce.map.output.compress.codec(在mapred-site.xml中配置) |
org.apache.hadoop.io.compress.DefaultCodec |
mapper输出 |
企业多使用LZO或Snappy编解码器在此阶段压缩数据 |
|
mapreduce.output.fileoutputformat.compress(在mapred-site.xml中配置) |
false |
reducer输出 |
这个参数设为true启用压缩 |
|
mapreduce.output.fileoutputformat.compress.codec(在mapred-site.xml中配置) |
org.apache.hadoop.io.compress.DefaultCodec |
reducer输出 |
使用标准工具或者编解码器,如gzip和bzip2 |
(七) 压缩实操案例1-Map输出端采用压缩
即使你的MapReduce的输入输出文件都是未压缩的文件,你仍然可以对Map任务的中间结果输出做压缩,因为它要写在硬盘并且通过网络传输到Reduce节点,对其压缩可以提高很多性能,这些工作只要设置两个属性即可,我们来看下代码怎么设置。
给大家提供的Hadoop源码支持的压缩格式有:BZip2Codec、DefaultCodec
在driver中修改代码
package com.root.mapreduce.compress;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.io.compress.BZip2Codec;

import org.apache.hadoop.io.compress.CompressionCodec;

import org.apache.hadoop.io.compress.GzipCodec;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;


public class WordCountDriver {


public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {

Configuration conf = new Configuration();

// 开启map端输出压缩

conf.setBoolean("mapreduce.map.output.compress", true);

// 设置map端输出压缩方式

conf.setClass("mapreduce.map.output.compress.codec", BZip2Codec.class,CompressionCodec.class);

Job job = Job.getInstance(conf);

// 省略其他.....


System.exit(result ? 0 : 1);

}

}
其他的Mapper和Reducer代码保持不变。
运行之后,发现输出的结果格式没有变化,因为它是中间过程。
(八)压缩实操案例2-Reduce输出端采用压缩
基于WordCount案例,只需要在dirvier类的代码中,去设置在reduce端输出压缩开启,并设置压缩的方式即可。
对应的代码有如下两行,其他的代码不动。
	// 设置reduce端输出压缩开启
		FileOutputFormat.setCompressOutput(job, true);

		// 设置压缩的方式
   	     // FileOutputFormat.setOutputCompressorClass(job, BZip2Codec.class);
        FileOutputFormat.setOutputCompressorClass(job, GzipCodec.class);
         // FileOutputFormat.setOutputCompressorClass(job, DefaultCodec.class);

		boolean result = job.waitForCompletion(true);
         System.exit(result?0:1);
	}
}
其他的Mapper和Reducer代码保持不变。
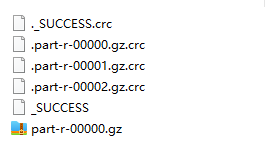
运行代码之后,是否在输出结果中看到了压缩的格式。
「智能机器人开发者大赛」官方平台,致力于为开发者和参赛选手提供赛事技术指导、行业标准解读及团队实战案例解析;聚焦智能机器人开发全栈技术闭环,助力开发者攻克技术瓶颈,促进软硬件集成、场景应用及商业化落地的深度研讨。 加入智能机器人开发者社区iRobot Developer,与全球极客并肩突破技术边界,定义机器人开发的未来范式!
更多推荐
 54
 0
- 0


 已为社区贡献1条内容

所有评论(0)