【Redis#3】:Redis 的安装和使用

📃个人主页:island1314
⛺️ 欢迎关注:👍点赞 👂🏽留言 😍收藏 💞 💞 💞
- 生活总是不会一帆风顺,前进的道路也不会永远一马平川,如何面对挫折影响人生走向 – 《人民日报》
一、安装 Redis
① 首先确保你的系统是最新的。可以通过运行以下命令来更新你的软件包列表:
sudo apt update
② 使用apt安装Redis
sudo apt install redis -y

lighthouse@VM-8-10-ubuntu:~$ sudo netstat -nap | grep redis
tcp        0      0 127.0.0.1:6379          0.0.0.0:*               LISTEN      3698310/redis-serve
tcp6       0      0 ::1:6379                :::*                    LISTEN      3698310/redis-serve
1. 配置Redis支持远程连接
默认情况下,Redis仅监听本地回环接口(127.0.0.1),这意味着只有在同一台机器上的客户端才能连接到Redis服务器。为了允许从其他机器进行连接,你需要编辑Redis的配置文件。
1)打开Redis配置文件:使用文本编辑器(如nano或vim)打开Redis配置文件/etc/redis/redis.conf
sudo vim /etc/redis/redis.conf
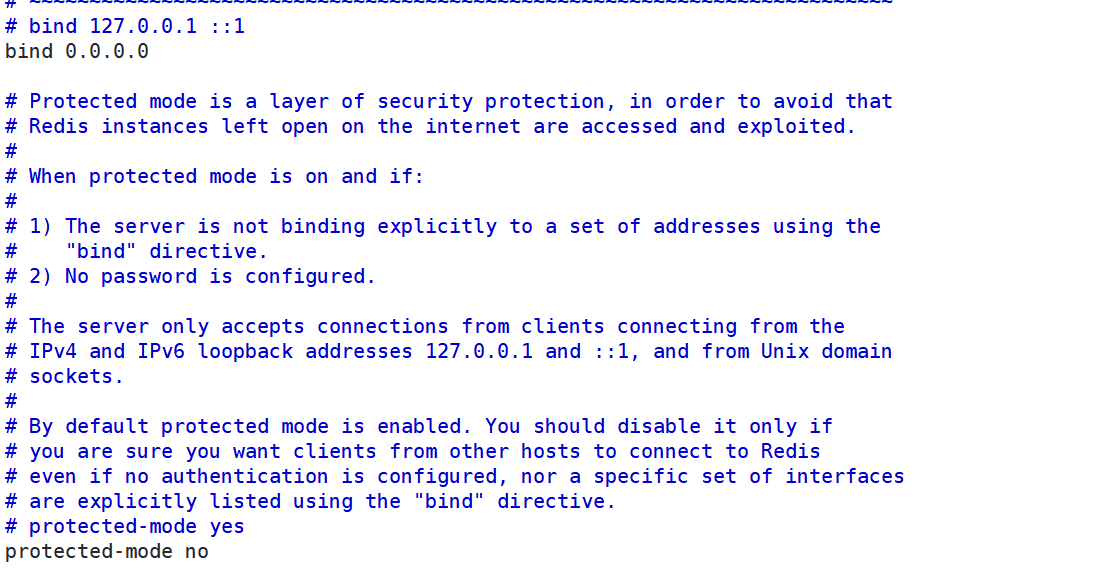
2)修改绑定地址:找到bind指令,默认可能设置为127.0.0.1。将其更改为0.0.0.0,以便Redis监听所有网络接口。如果bind行前面有注释符号(#),请删除该符号以取消注释此行
# bind 127.0.0.1
bind 0.0.0.0
3)关闭保护模式:找到protected-mode指令,并将其值从yes更改为no。保护模式是一种安全特性,当Redis没有密码保护并且监听非本地网络接口时,会阻止某些命令的执行。由于我们正在开放Redis以接受远程连接,因此需要关闭保护模式:
protected-mode no
结果如下:
2. 重启 Redis 服务
为了让更改生效,你需要重启Redis服务:
sudo service redis-server restart # 重启 redis 服务

# 其他指令补充
sudo service redis-server start  # 启动 redis 服务
sudo service redis-server stop   # 停止 redis 服务
sudo service redis-server status # 查看 redis 服务状态


# 操作结果如下:
lighthouse@VM-8-10-ubuntu:~$ sudo service redis-server status
● redis-server.service - Advanced key-value store
     Loaded: loaded (/lib/systemd/system/redis-server.service; enabled; vendor preset: ena>
     Active: active (running) since Sun 2025-06-01 21:40:46 CST; 3s ago
       Docs: http://redis.io/documentation,
             man:redis-server(1)
   Main PID: 3708413 (redis-server)
     Status: "Ready to accept connections"
      Tasks: 5 (limit: 3943)
     Memory: 2.6M
        CPU: 60ms
     CGroup: /system.slice/redis-server.service
             └─3708413 "/usr/bin/redis-server 0.0.0.0:6379" "" "" "" "" "" "" "" "" "" "" >
补充:
① 持久化文件存储目录
lighthouse@VM-8-10-ubuntu:~$ sudo ls /var/lib/redis/
dump.rdb
- Redis 持久化生产的 RDB 和 AOF 文件都默认生成于该目录下
② 日志文件目录
lighthouse@VM-8-10-ubuntu:~$ sudo ls /var/log/redis/
redis-server.log
/var/log/redis/目录下会保存Redis运行期间生产的日志文件,默认按照天进行分割,并且会将一定日期的日子文件使用gzip格式压缩保存。可以使用任意文本编辑器打开
3. 连接服务器
现在我们已经启动了Redis服务,下面将介绍如何使用 redis-cli 连接、操作Redis服务
redis-cli 可以使用两种方式连接Redis服务器
(1)交互式方式:通过 redis-cli-h{host}-p{port} 的方式连接到Redis 服务,后续所有的操作都是通过交互式的方式实现,不需要再执行 redis-cli 了,例如:
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379
127.0.0.1:6379> ping
PONG
127.0.0.1:6379> set key hello
OK
127.0.0.1:6379> get key
"hello"
(2)命令方式:用 redis-cli-h{host}-p{port}{command} 就可以直接得到命令的返回结果,例如:
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 ping
PONG
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 set key hello
OK
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 get key
"hello"
此时就算访问成功了,然后 Ctrl + d 就可以成功退出
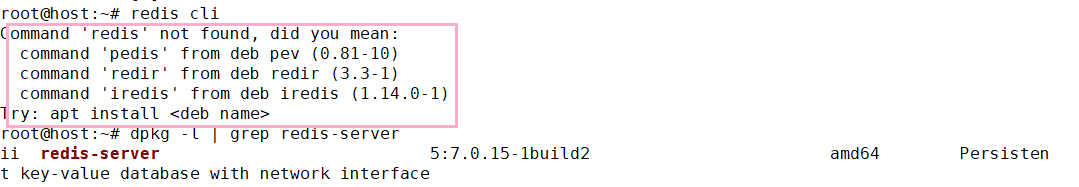
有些人进行客户端连接测试的时候,可能会出现如下问题:>
解决办法
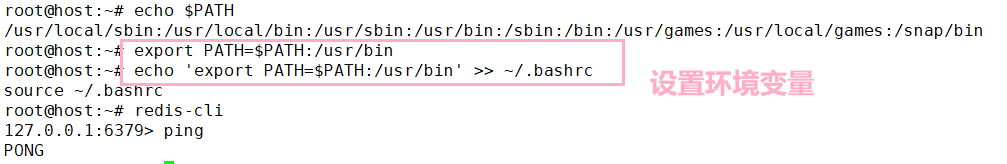
密码设置方式如下:(不需要重启redis服务的密码设置方式)
127.0.0.1:6379> config set requirepass 123456
OK
127.0.0.1:6379> config get requirepass
1) "requirepass"
2) "123456"

# 退出重进
lighthouse@VM-8-10-ubuntu:~$ redis-cli
127.0.0.1:6379> ping
(error) NOAUTH Authentication required.
127.0.0.1:6379> auth 123456
OK
127.0.0.1:6379> ping
PONG
注意:通过命令行修改了密码之后,配置文件的requirepass字段后面的密码是不会随之修改的。
为啥要设置密码,就是因为避免 redis 的 key 变成 backup([解决redis的key都变成了backup,redis所有缓存被清空_)
注意事项
- 开启Redis的远程访问前,请确保已经配置了合适的防火墙规则,只允许受信任的IP地址访问Redis端口
- 考虑设置一个密码来增强安全性。可以在
/etc/redis/redis.conf中找到 requirepass 指令并设置一个强密码 - 如果你的Redis服务器暴露在互联网上,建议使用SSL/TLS加密通信,以防止数据泄露
4. 关于 Redis 客户端
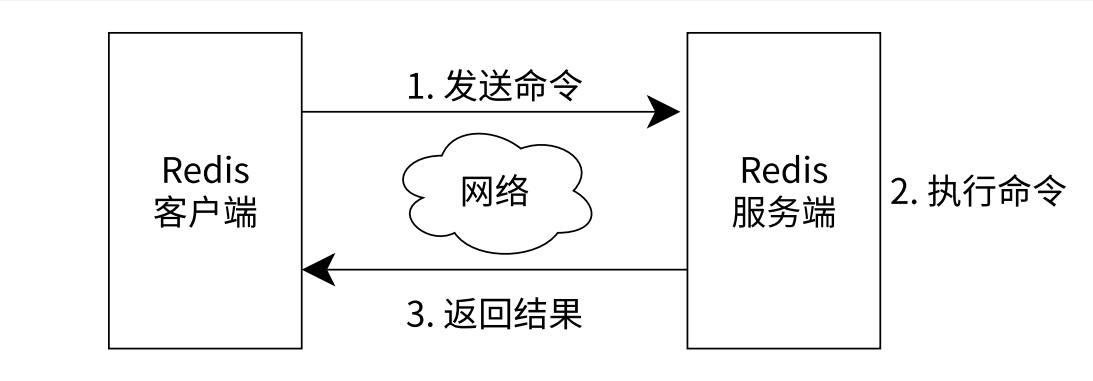
Redis 客户端也是一个客户端-服务器结构的程序!!,MySQL 也是(由于我们连接的Redis服务位于127.0.0.1,端口使用的是默认的6379端⼝,所以可以省略 -h{host}-p{port} )
- Redis 客户端和服务端可以在同一个主机上,也可以在不同主机上。(当前阶段,我们一般只有一台机器,此时客户端和服务端就是在同一个机器上)
如下是 Redis 客户端和服务器的交互过程
二、Redis 常用命令
注意:Redis 中的命令是不区分大小写的
1. get 和 set
🦈 Redis 中是使用键值对来进行存储的,所以 get 是根据 key 来取 Value 的,而 set 是来设置键值对
SET
- 功能:设置一个键值对
- 使用方法:
set key value - 注意事项:
key和value都是字符串,可选地使用单引号或双引号包围
案例
127.0.0.1:6379> set key1 value1
OK
127.0.0.1:6379> set key3 value3
OK
127.0.0.1:6379> set 'key2' "value2"
OK
GET
- 功能:获取键对应的值
- 使用方法:
get key - 特点:如果查询的键不存在,则返回
nil
案例
127.0.0.1:6379> get key1
"value1"
127.0.0.1:6379> get key2
"value2"
127.0.0.1:6379> get key3
"value3"
127.0.0.1:6379> get key
(nil)
2. 基本全局命令
Redis 可以看成是一个网络版本的哈希表,它支持很多的数据结构,key 固定是字符串,但是 Value可以是多种多样的数据结构,下面讲述的就是全局命令,可以搭配各种各样的数据结构
2.1 KEYS
- 功能:获取所有符合特定模式的键。
- 使用方法:
keys pattern
pattern 是什么?
- 表示的意思是:一个包含特殊符号的字符串,存在的意义是来描述,找的字符串是什么样子的
常见模式
?:匹配任何一个字符。*:匹配任意数量的任意字符[abc]:匹配a、b、c中的一个[^a]:排除a,匹配其他任何字符。[a-c]:匹配a到c范围内的字符。
样例
h?llo 匹配 hello , hallo 和 hxllo
h*llo 匹配 hllo 和 heeeello
h[ae]llo 匹配 hello 和 hallo 但不匹配 hillo
h[^e]llo 匹配 hallo , hbllo , … 但不匹配 hello
h[a-b]llo 匹配 hallo 和 hbllo
注意:key 命令的时间复杂度O ( N ) , 在生产环境上,一般都会禁用KEYS命令,尤其是 KEYS *
- 生产环境上的key可能会非常多,而Redis是一个单线程服务器,执行KEYS *的时间非常长,就会使Redis服务器被阻塞,无法给其他客户端提供服务
- 此时其他的查询Redis操作超时了,就直接会去查数据库,突然一大波数据突然来了,MySQL可能措手不及,就直接挂了
2.2 EXISTS
- 功能:检查一个或多个键是否存在。
- 使用方法:
exists key [key ...] - 特点:可以同时检查多个键,返回存在的键的数量。由于使用哈希表存储数据,此操作的时间复杂度为 O(1)
lighthouse@VM-8-10-ubuntu:code$ redis-cli
127.0.0.1:6379> set hello 1
OK
127.0.0.1:6379> set hallo 2
OK
127.0.0.1:6379> set hbllo 3
OK
127.0.0.1:6379> set hllo 4
OK
127.0.0.1:6379> set heeeeeelo 5
OK

127.0.0.1:6379> exists hello hallo
(integer) 2
127.0.0.1:6379> exists hello
(integer) 1
127.0.0.1:6379> exists hallo
(integer) 1
EXISTS key1 key2 和分开写 EXISTS key1、EXISTS key2 有什么区别?
- 分开的写法,会产生更多的轮次的网络通信
- 此时跟直接操作内存相比,效率比较低,成本比较高
那为什么要这样进行一次请求多个呢?这是考虑到了网络服务,Redis 和 HTTP 的请求响应机制是一样的,这就意味着如果每次都请求,会消耗一定的网络资源,但是如果采用一次去检查多个的情况(减少网络通信的次数),就不会这样,相当于会节省一部分的网络资源
2.3 DEL
- 功能:删除一个或多个键
- 使用方法:
del key [key ...] - 特点:支持一次删除多个键
案例
127.0.0.1:6379> keys *
1) "hallo"
2) "hbllo"
3) "heeeeeelo"
4) "hello"
5) "hllo"

127.0.0.1:6379> del hllo hallo
(integer) 2
127.0.0.1:6379> keys *
1) "hbllo"
2) "heeeeeelo"
3) "hello"
这里值得注意的是,Redis 数据被删除,要看它是否是一个数据库,如果它作为缓存,那问题不算特别大,但是如果是作为数据库,那就相当于在 MySQL 中丢失了数据,这就是一个比较严重的错误了
针对于 Redis 的误删数据的错误,要根据具体情况具体分析
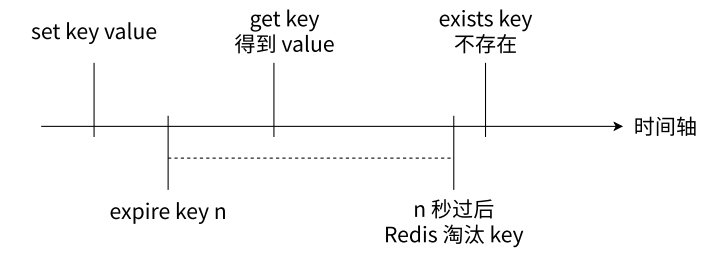
2.5 EXPIRE
- 功能:给指定的 key 设置过期时间,key 存活时间超过这个指定的值,就会被自动删除(以 秒为单位)
- 使用方法:
expire key seconds - 返回值:成功返回 1,失败(例如键不存在)返回 0
127.0.0.1:6379> expire hbllo 2
(integer) 1
127.0.0.1:6379> keys *
1) "heeeeeelo"
2) "hello"
关于 TTL
TTL:获取键的剩余生存时间(以秒为单位),全称是 time to live(ttl也有毫秒级别的指令pttl)
- 返回值:剩余过期时间。-1表示没有关联过期时间,-2表示 key不存在。
127.0.0.1:6379> set hello 100
OK
127.0.0.1:6379> ttl hello
(integer) -1
127.0.0.1:6379> expire hello 10
(integer) 1
127.0.0.1:6379> ttl hello
(integer) 4
127.0.0.1:6379> ttl hello
(integer) -2
Redis 删除过期键策略
🏮 Redis 的 **定期删除策略(Periodic Key Eviction)**是 Redis 为了在内存有限的情况下,自动清理一些不再需要的键,以释放内存的一种机制
Redis 对设置了过期时间的键(通过 EXPIRE 或 PEXPIRE 设置),有以下三种删除策略来处理这些键:
| 策略 | 描述 | 优点 | 缺点 |
|---|---|---|---|
| 惰性删除(Lazy Expiration) | 只有当访问一个键时才检查是否过期,如果过期则删除 | 节省 CPU 资源 | 过期键可能长期滞留内存,浪费内存 |
| 定期删除(Active Expiration) | 每隔一段时间主动随机抽查一批键并删除其中过期的键 | 平衡内存与性能 | 实现较复杂,不能保证及时删除所有过期键 |
| 定时删除(Timed Deletion) | 创建一个定时器,在键到期时立即删除 | 最及时 | 内存友好但消耗大量 CPU 和内存资源 |
Redis 实际使用的是前两种策略的结合:惰性删除 + 定期删除
原因:因为Redis内部要存储不少数据,轮询一遍所有数据要浪费很多时间,所以不会遍历所有数据判断过期。而是等待用户访问数据才删除,或者抽样检查删除,以降低删除过期数据带来的时间浪费
定期删除机制详解
Redis 默认每秒运行一次定期删除任务 (由 hz 配置控制频率,默认 hz=10,即每 100ms 执行一次),其流程如下:
(1)随机抽查数据库:Redis 会从所有数据库中随机选择一部分数据库(默认每次选 16 个)
(2)从每个选中的数据库中随机选取键:在每个选中的数据库中,随机抽取一定数量的设置了过期时间的键(默认 20 个)
(3)检查并删除过期键:如果发现某个键已经过期,则删除它
(4)统计过期键比例:如果在这次抽查中,超过 25% 的键是过期的(即 5 个或以上),Redis 会重复这一过程,直到抽查的比例低于 25% 或者达到最大循环次数(受 maxmemory-samples 影响)。
⚠️ 注意:这种机制是“概率性的”,意味着不是所有过期键都能被及时清除。
效果:尽管这两种策略结合使用,整体效果仍不尽如人意,可能会导致许多过期的键未被及时删除
补充:Redis 并没有采取定时器的方式来实现过期键的删除
那么为啥 Redis 不采用 定时器 的方式删除过期键呢?
定时器作用:如果有多个键过期,可以通过一个定时器在高效节省 CPU 的前提下处理多个键
redis 为什么不采用定时器
原因:
- 多线程引入:基于定时器实现势必会引入多线程。
- 单线程基础:Redis 早期版本奠定了单线程的基础,引入多线程会打破作者的初衷。
通过一些策略和方法,Redis 基本在处理过期键和内存管理方面取得了平衡,既保持了单线程的简洁性和高效性,又尽量减少了过期键的残留。
2.6 TYPE
- 功能:返回键对应的值的类型。
- 使用方法:
type key - 返回值:none(不存在), string, list, set(集合), zset(有序集), hash, stream
- 时间复杂度:O ( 1 )
127.0.0.1:6379> set key1 1
OK
127.0.0.1:6379> lpush key2 2
(integer) 1
127.0.0.1:6379> sadd key3 3
(integer) 1
127.0.0.1:6379> type key1
string
127.0.0.1:6379> type key2
list
127.0.0.1:6379> type key3
set
2.7 FLUSHALL
- 功能:删除Redis中所有数据库的数据。
- 使用方法:
flushall - 注意:在生产环境中谨慎使用此命令,以免造成数据丢失。
三、Redis 对象类型及编码
Redis中的每个对象都由一个redisObject结构表示,该结构中和保存数据有关的三个属性分别是type属性、 encoding属性和ptr属性:
typedef struct redisObiect{
	//类型
	unsigned type:4;
	//编码
	unsigned encoding:4;
	//指向底层数据结构的指针
	void *ptr;
}
Redis使用对象来表示数据库中的键和值,每次当我们在Redis的数据库中新创建一个键值对时,我们至少会创建两个对象,一个对象用作键值对的健(键对象),另一个对象用作键值对的值(值对象)。
其中Redis的键对象都是字符串对象,而Redis的值对象主要有字符串、哈希、列表、集合、有序集合几种。其分别对应的内部编码和底层数据结构如下图所示:
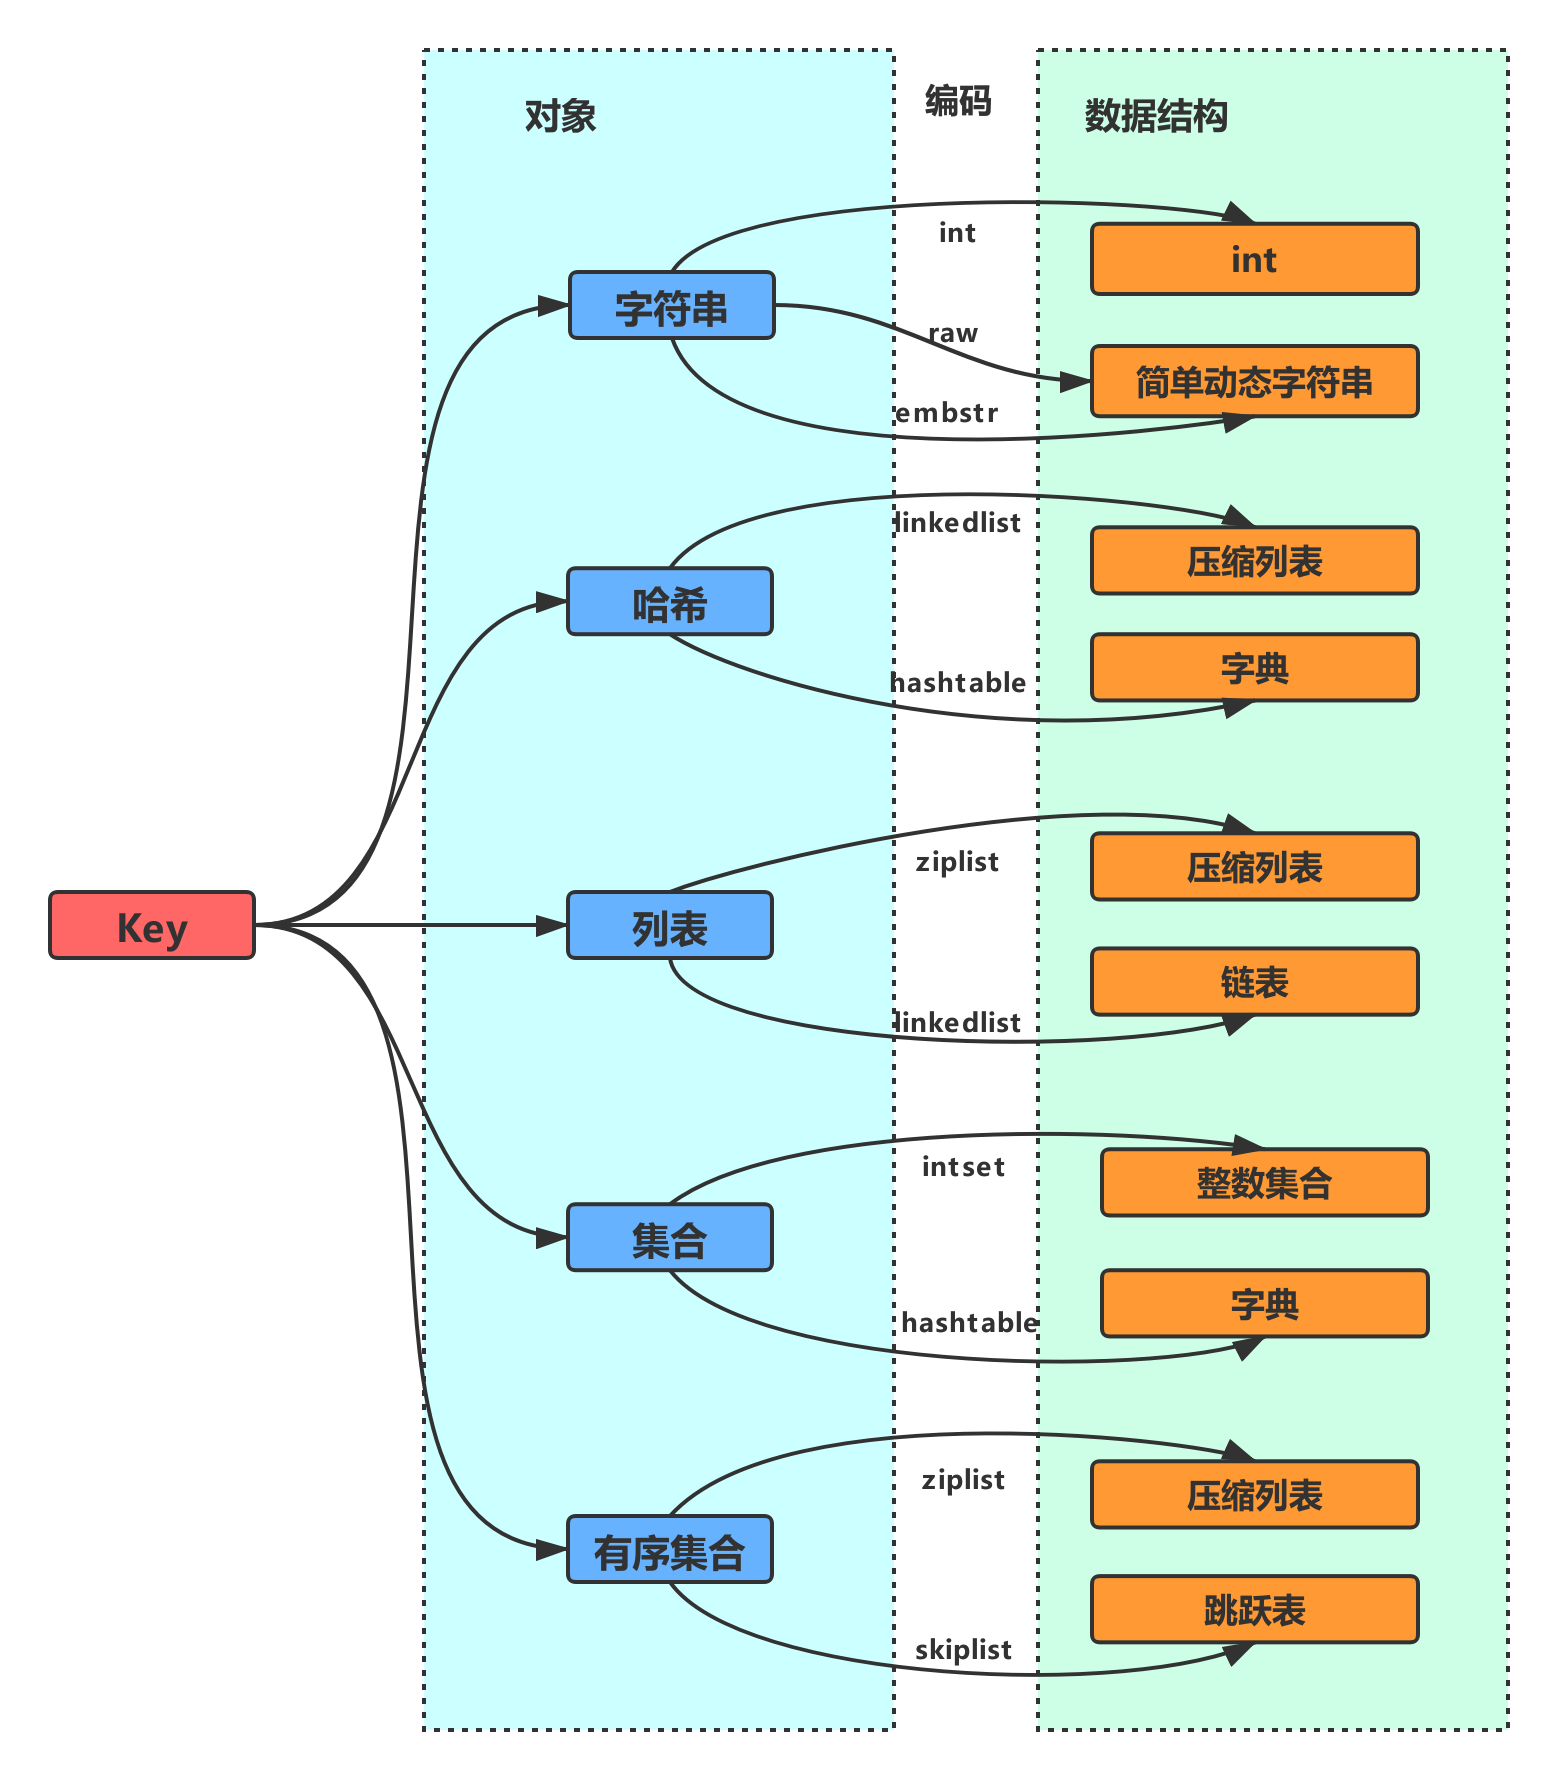
可以在 Redis 官网上找到 Redis 数据结构非常详细的介绍:Data Structures - Redis
✅ 基础数据类型:
| 类型 | 特点 | 示例命令 |
|---|---|---|
| String | 最基础的类型,可以是字符串、整数或浮点数 | SET,GET,INCR |
| Hash | 存储字段-值对,适合存储对象 | HSET,HGET,HGETALL |
| List | 有序、可重复的字符串列表 | LPUSH,RPUSH,LPOP |
| Set | 无序、不重复的字符串集合 | SADD,SMEMBERS,SINTER |
| Sorted Set (ZSet) | 带权重的集合,按分值排序 | ZADD,ZRANGE,ZSCORE |
✅ 扩展数据类型:
| 类型 | 特点 | 示例命令 |
|---|---|---|
| Stream | 消息队列结构,支持持久化、消费者组等 | XADD,XREAD,XGROUP |
| Bitmap | 位操作结构,用于高效统计 | SETBIT,GETBIT,BITCOUNT |
| Bitfield | 更精细的位操作控制 | BITFIELD |
| Geospatial | 地理位置索引,基于 Sorted Set 实现 | GEOADD,GEORADIUS |
这些数据结构构成了 Redis 的 API 接口,用户通过这些命令进行操作时,不需要关心底层是如何实现的 。
Redis 在底层实现上述数据结构的过程中,会在源码的角度上对于上述的内容进行特定的优化,这样的优化的主要目的是为了实现出节省时间和节省空间的效果,具体的优化方法当然还是要看的是具体的内容
Redis 在外部承诺,对于哈希表来说,保证用户在进行增删查改这些操作都能保证是O(1),但是具体内部的实现来说,其实并不是一个传统意义的哈希表,在特定的实现场景下会使用其他的数据结构来实现,但是总体上来说,还是能够保证时间复杂度是满足具体的要求的
- 所以我们说,对于 Redis 内部的数据结构或者说是数据类型来说,这是 Redis 承诺给用户的,但是在其内部的实现中,可能会不同,具体的方式是有编码方式来进行决定的,因此换句话说,对于同一个数据结构来说,内部会有不同的实现方式,在不同的场景下会使用不同的方式,但是作为上层的使用者,其实是感知不到这样的存在的
Redis中的对象,大都是通过多种数据结构来实现的,为什么会这样设计呢?用一种固定的数据结构来实现,不是更加简单吗?
四、Redis 编码方式
TYPE 命令实际返回的就是当前键的数据结构类型,但这些只是Redis对外的数据结构
Redis这样设计多种数据结构有两个好处:
- 可以自由改进内部编码,而对外的数据结构和命令没有影响,这样一旦开发出更优秀的内部编码,无需改动外部数据结构和命令,例如Redis3.2提供了quicklist,其结合了ziplist和linkedlist两者
的优势,为列表类型提供了一种更为优秀的内部编码实现,而对外部用户来说基本感知不到。 这一点比较像程序设计中的分层架构。 - 多种内部编码实现可以在不同场景下发挥各自的优势,从而优化对象在不同场景下的使用效率。例如
ziplist比较节省内存,但是在列表元素比较多的情况下,性能会有所下降,这时候Redis会根据配置选项将列表类型的内部实现转换linkedlist。 (后续文章将根据具体对象介绍)
每个 Redis 对象(robj)都有一个属性 encoding,用来表示其底层使用的具体实现方式。
💡 你可以使用
OBJECT ENCODING key来查看某个键的实际编码方式
例如:
127.0.0.1:6379> SET name "Tom"
OK
127.0.0.1:6379> OBJECT ENCODING name
"embstr"
Redis 对不同数据类型使用不同的内部编码以提高性能和内存使用效率:
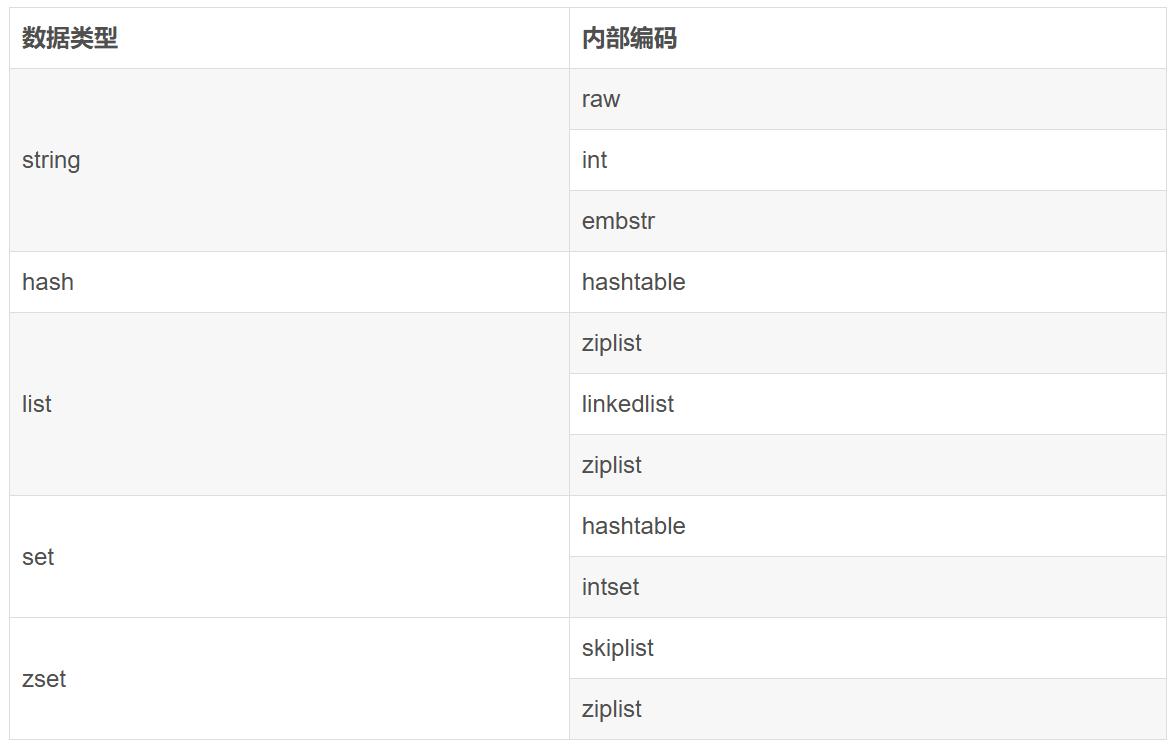
1. String
- int:当存储的值为整数,且值的大小可以用 long 类型表示时,Redis 使用 int 编码。在 int 编码中,String 对象的实际值会被存储在一个 long 类型的整数中。这种编码方式的 优点:存储空间小,且无需进行额外的解码操作( 只有整数才会使用int,如果是浮点数, Redis内部其实先将浮点数转化为字符串值,然后再保存)
- embstr:当存储的值为字符串,且长度小于等于 44 字节时,Redis 使用 embstr 编码。在 embstr 编码中,String 对象的实际值会被存储在一个特殊的字符串对象中,该对象包含了字符串的长度和字符数组的指针,但是不包含额外的空间。这种编码方式的 优点:存储空间小,且无需进行额外的解码操作,但是由于需要额外的内存分配,可能会影响性能。
- raw:当存储的值为字符串,且长度小于等于 44 字节时,Redis 使用
raw编码。在 raw 编码中,String 对象的实际值会被存储在一个简单的 字符串对象 中,该对象包含了字符串的长度和字符数组的指针。这种编码方式的 优点:存储空间小,且无需进行额外的解码操作。
默认情况下,值以字符串形式传入,如果Redis检测到字符串为数字,则转换为int存储,从而节省空间。例如,字符串"1234567890"若作为字符串存储需要10字节,而转换为int后仅需8字节
明明没有超过阈值,为什么变成raw?
- 对于
embstr,由于其实现是只读的,因此在对embstr对象进行修改时,都会先 转化为 raw 再进行修改。因此,只要是修改embstr对象,修改后的对象一定是 raw 的,无论是否达到了 44 个字节。
2. Hash
- hashtable:hashtable是哈希表,适用于存储大量数据,支持高效的查找和插入操作
- ziplist:一种 压缩列表,适用于存储少量、短字符串,具有内存效率高、遍历速度快的优点,但不擅长修改操作,当数据量增多时,Redis会将ziplist优化为 hashtable
listpack(替代 ziplist) 新版本中用于小对象的紧凑存储
那到此,可能会关心的问题是,为什么要进行压缩?意义在哪呢?
- 因为 Redis 内部是有很多的 key 值的,这就意味着对于某些 key 的 Value 是一个 hash,所以当 key 值比较多的时候,对应的 hash 结构也会比较多,但是每一个 hash 的实际占用其实不大,因此就可以选择去尽量的压缩,这样压缩后就可以使得整体上的占用变的比较少了
- 核心意义就是:在 Hash 数据量较小的情况下,通过紧凑的内存布局,显著降低内存占用,从而提升整体内存利用率
压缩的好处
- 节省内存:所有元素连续存储,没有额外指针开销
- 减少碎片:单块内存分配,避免频繁的小块内存分配
- 适合小对象:当 Hash 字段数量较少时效率更高
- 自动切换:当 Hash 变大时,Redis 会自动切换到 hashtable 编码
3. List
- linkedlist:标准链表实现,每个节点都是独立对象,占用内存大
- ziplist:当链表元素较少时,采用压缩列表以节省空间
Redis 3.2后,List统一使用 quicklist ,结合了 linklist 和 ziplist 的优点,类似于 C++中的 deque, 即基本结构为链表,每个链表节点包含一个压缩列表。
4. Set
- hashtable:基于哈希表实现的集合,提供O(1)时间复杂度的操作。
- intset:如果集合成员全部为整数,则使用整数集合进行优化。
在现代编程语言中,常用平衡二叉搜索树(如红黑树)实现Set,时间复杂度为O(log N),而Redis选择哈希表实现Set以获得更高的效率。
5. ZSet (Sorted Set)
- skiplist + dict:大集合使用跳表和字典结合的方式,保证插入和查询效率
- 跳表是一种高效的搜索结构,与平衡二叉搜索树处于同一级别的时间复杂度,但提供了更好的并发性能,用于快速查找排序后的元素,时间复杂度为O(log N)
- ziplist / listpack:当有序集合元素较少时,使用 压缩列表 以节省空间。
内部编码的好处:
-
可以改进内部编码,而对外的数据结构和命令没有任何影响,这样⼀旦开发出更优秀的内部编码, 无需改动外部数据结构和命令
- 例如:Redis3.2提供了
quicklist,结合了ziplist和linkedlist两者的优势,为列表类型提供了⼀种更为优秀的内部编码实现,而对用户来说基本无感知
- 例如:Redis3.2提供了
-
多种内部编码实现可以在不同场景下发挥各自的优势
- 例如:
ziplist比较节省内存,但是在列表元素比较多的情况下,性能会下降,这时候Redis会根据配置选项将列表类型的内部实现转换为linkedlist,整个过程用户同样无感知
- 例如:
小结:Redis 对外提供统一的数据结构接口(如 String、Hash 等),但 内部根据数据量、内容、性能需求等动态选择最优的底层编码方式 ,从而实现 高性能 + 高效内存利用 的双重目标例如:
- 对于整数和短字符串,Redis通过特殊编码(如int和embstr)来节省内存
- 而对于集合和有序集合,Redis通过哈希表和跳表等数据结构来提高操作的效率
五、单线程架构
Redis 的“单线程”到底指的是什么?
- Redis 的核心网络 I/O 和键值操作(命令处理)是在一个单线程中完成的。
也就是说:
- 所有的客户端请求(读写)都是由一个主线程串行处理。
- 这个主线程负责:
- 接收客户端连接
- 解析命令
- 执行命令
- 返回结果
这种设计被称为 单线程的事件循环模型(Event Loop)
1. Redis 单线程概念
❗ Redis 6.0 引入了多线程 I/O 特性 ,但核心命令执行仍然是单线程的。
Redis 多线程的结构(以 Redis 6.0+ 为例)
| 模块 | 是否多线程 | 描述 |
|---|---|---|
| I/O 读写(网络请求) | ✅ 多线程 | 使用多个 I/O 线程并行读取/写入客户端数据 |
| 命令解析与执行 | ❌ 单线程 | 主线程串行执行 Redis 命令 |
| 持久化、慢日志等后台任务 | ✅ 多线程 | 由独立线程或进程处理 |
- 单线程处理请求:Redis 使用一个线程处理所有的客户端请求,但这并不意味着Redis服务器内部只有一个线程。
- 内部多线程:Redis 内部确实有多个线程,但这些线程主要用于处理网络 I/O。
- 命令执行顺序:尽管多个客户端看起来是同时发起请求,但从微观角度看,这些命令仍然是按线性顺序执行的,且命令的执行顺序是不确定的,但绝不会有两个命令同时执行。
2. 操作演示
现在开启了三个redis-cli客户端同时执行命令
-
客户端 1 对 counter 设置初始值
127.0.0.1:6379> set counter 1 OK -
客户端 2 对 counter 做自增操作
127.0.0.1:6379> incr counter (integer) 2 -
客户端 3 对 counter 做自增操作
127.0.0.1:6379> incr counter
(integer) 3
我们已经知道从客户端发送的命令经历了:发送命令、执行命令、返回结果三个阶段,其中重点关注第2步。
- 所谓的 Redis是采用单线程模型执行命令的是指:虽然三个客户端看起来是同时要求 Redis 去执行命令的,但微观角度,这些命令还是采用线性方式去执行的,只是原则上命令的执行顺序是不确定的,但一定不会有两条命令被同步执行。
- 如下面图所示,可以想象 Redis内部只有一个服务窗口,多个客户端按照它们达到的先后顺序被排队在窗口前,依次接受 Redis 的服务,所以两条
incr命令无论执行顺序,结果一定是2,不会发生并发问题,这个就是 Redis 的单线程执行模型。
① 宏观上同时要求服务的客户端
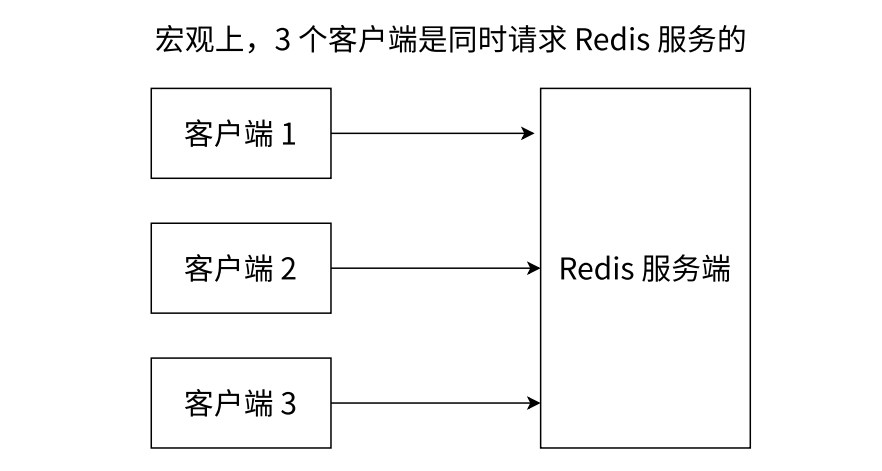
② 微观上客户端发送命令的时间有先后次序的

③ Redis 的单线程模型
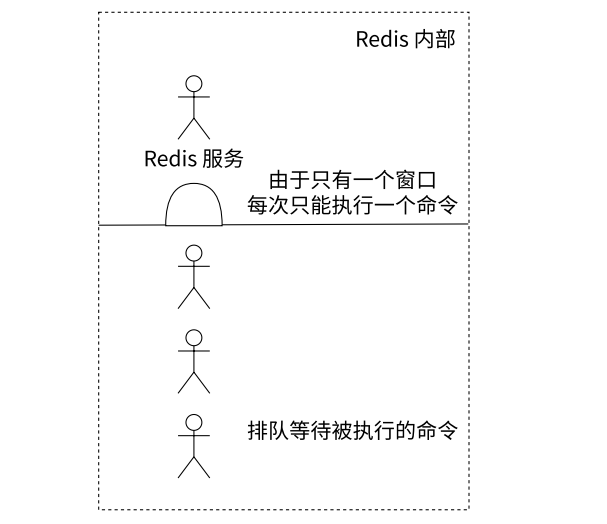
理解:并发请求与串行处理:虽然多个客户端并发发起请求,但Redis在处理这些请求时是单线程模型,确保所有请求在内部依然串行执行.
- 请求排队:多个请求同时到达Redis服务器时,会先在队列中排队,然后由Redis服务器逐个取出并执行,所以不存在之前学习的 多线程安全的 数据同步及加锁解决
- Redis 能够使用 单线程模型 很好的工作, 原因 主要在于 Redis 的核心业务逻辑都是 短平快 的,不太消耗 cpu 资源【即不太吃多核】,但是也有个弊端:Redis 必须要特别小心, 某个操作占用时间长, 就会阻塞其他命令的执行!
3. Redis 单线程模型如何支持高并发?(效率高)
虽然 Redis 是单线程处理命令,但它依然可以支持数十万 QPS ,这得益于以下几个关键技术:
1. 非阻塞 I/O(Non-blocking I/O)
- Redis 使用
epoll(Linux)、kqueue(BSD)等 I/O 多路复用技术。 - 可以同时监听大量客户端连接,只在有事件发生时才处理。
2. 事件驱动架构(Event-driven)
- Redis 使用事件循环(event loop)处理所有事件(如连接、读、写)。
- 所有事件都在一个主循环中被顺序处理。
3. 高效的内存访问
- Redis 数据全部存储在内存中,读写速度极快。
- 避免了磁盘 I/O 的延迟问题。
4. 命令本身执行时间短
- 大多数 Redis 命令的时间复杂度是 O(1) 或 O(log N),非常高效。
5. 简化数据结构和算法
- 单线程避免了线程切换和竞态产⽣的消耗。单线程可以简化数据结构和算法的实现,让程序模型更简单
- 其次单线程避免了在线程竞争同⼀份共享数据时带来的切换和等待消耗
Redis 使用 I/O 多路复用模型
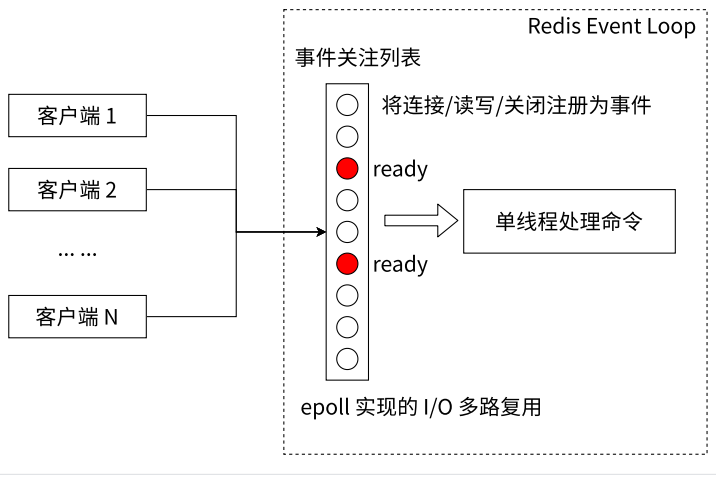
虽然单线程给 Redis 带来很多好处,但还是有一个致命的问题:对于单个命令的执行时间都是有要求的
- 如果某个命令执行过长,会导致其他命令全部处于等待队列中,迟迟等不到响应,造成客户端的阻塞,对于 Redis 这种高性能的服务来说是非常严重的,所以 Redis 是 面向快速执行场景 的数据库。
小结:Redis 的“单线程”模型是指其核心命令处理在一个线程中串行执行,但通过非阻塞 I/O、事件驱动和内存操作的优势,依然可以实现高性能、高并发的访问;Redis 6.0 开始引入多线程 I/O 来进一步提升吞吐能力,但核心逻辑依然是单线程的。
「智能机器人开发者大赛」官方平台,致力于为开发者和参赛选手提供赛事技术指导、行业标准解读及团队实战案例解析;聚焦智能机器人开发全栈技术闭环,助力开发者攻克技术瓶颈,促进软硬件集成、场景应用及商业化落地的深度研讨。 加入智能机器人开发者社区iRobot Developer,与全球极客并肩突破技术边界,定义机器人开发的未来范式!
更多推荐
 102
 0
- 0


 已为社区贡献2条内容

所有评论(0)