登录社区云,与社区用户共同成长
邀请您加入社区
学习了牛琨老师的课程后整理的学习笔记,用于日后复习一、大数据预处理的几个步骤1.数据预处理 2.数据清洗 3.数据集成 4.数据归约 5.数据变换 6.数据离散化 7.大数据预处理二、数据预处理现实中的数据大多是“脏”数据:①不完整 缺少属性值或仅仅包含聚集数据②含噪声 包含错误或存在偏离期望的离群值 比如:salary=“-10”,明显是错误数据③不一致 用于商品分类的部门编码存在差异 比如a
本文首次对训练后语言模型(PoLMs)进行了全面调查,系统地追踪了其从2018年ChatGPT的对齐起源到2025年DeepSeek-R1的推理里程碑的发展轨迹,并肯定了它们在推理精度、领域适应性和伦理完整性方面的变革性影响。作者评估了广泛的技术(即微调、对齐、推理、效率和集成与适应),综合了它们在专业、技术和交互领域的贡献,从法律分析到多模态理解。
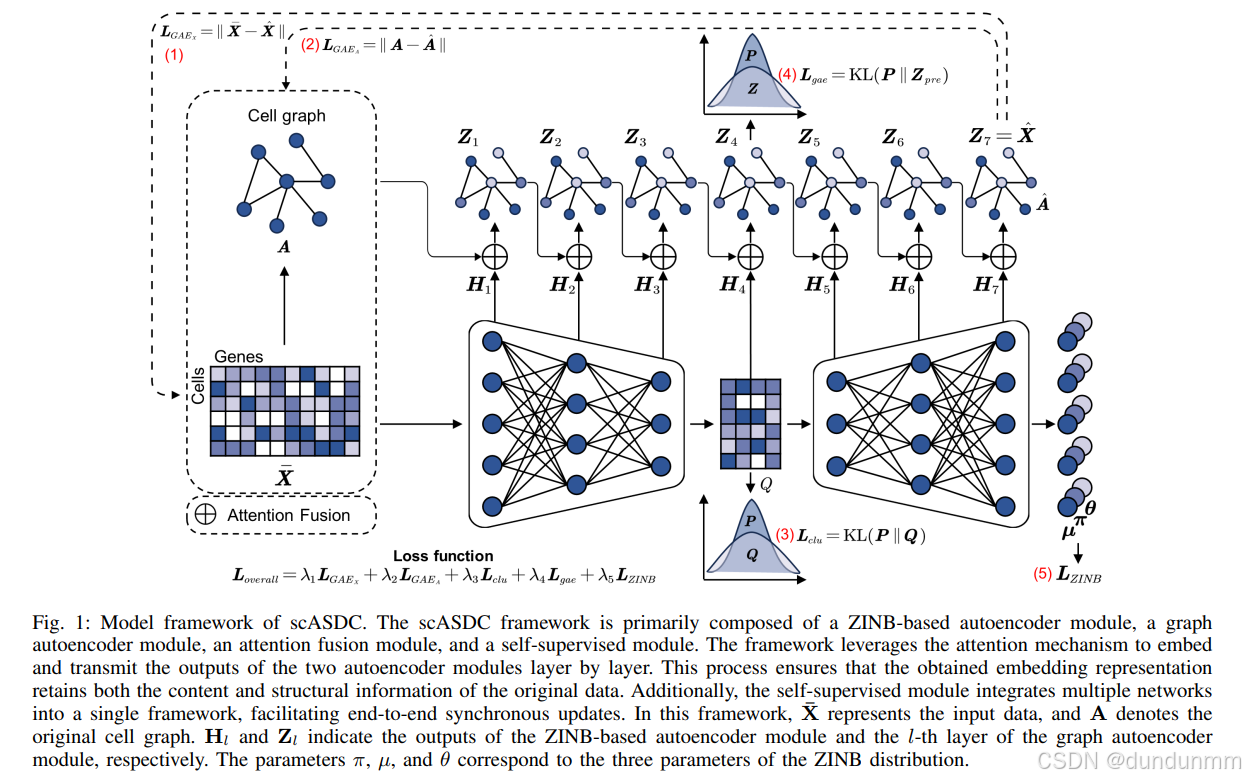
单细胞RNA测序(scRNA-seq)数据分析对于理解细胞异质性具有关键意义。然而,scRNA-seq数据固有的高稀疏性和复杂噪声模式对传统聚类方法提出了严峻挑战。为应对这些问题,我们提出了一种深度聚类方法——注意力增强的结构化深度嵌入图聚类(scASDC),该方法融合了多个先进模块,以提升聚类的准确性与鲁棒性。本文方法采用多层图卷积网络(GCN),以捕捉细胞之间的高阶结构关系,构成图自编码器模块
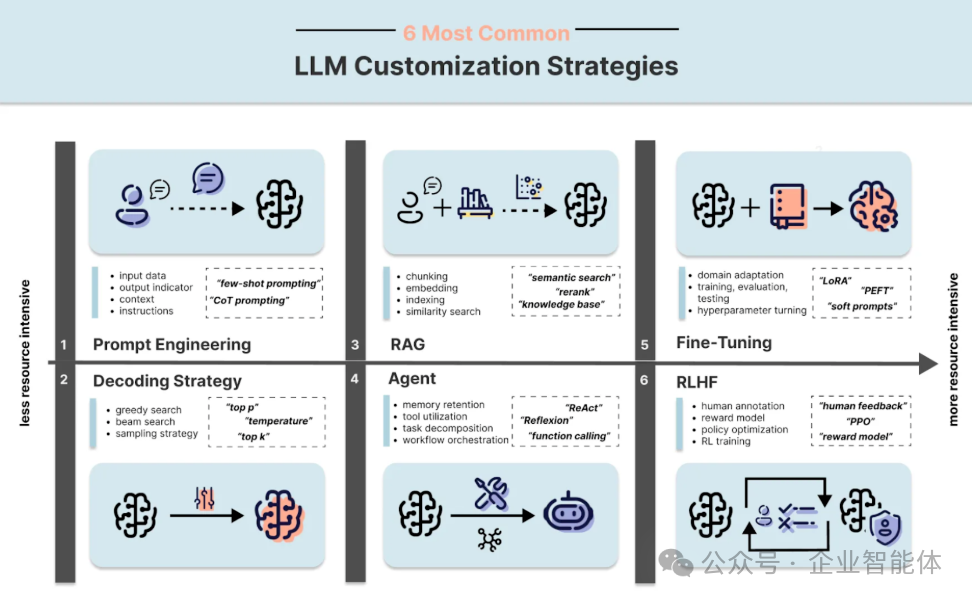
语言模型(LLM)属于深度学习模型,它通过自监督学习进行预训练,依靠海量数据和长时间的训练过程,构建起庞大的参数体系。在过去两年里,语言模型对自然语言处理领域进行了彻底变革,在文本理解与生成方面展现出了卓越的能力。然而,通用语言模型存在显著的应用局限性,难以满足特定业务和领域的需求。特别是在涉及企业专有数据或封闭环境的问题时,通用语言模型往往力不从心。此外,从头开始训练语言模型需要投入大量的数据和
作为大模型领域的“新兴战场”,越来越多的人在讨论如何入门、如何快速提升自己的能力。你是否也有过这样的困惑:想学大模型,但基础薄弱怎么办?到底该怎么学,才能在面试中脱颖而出?让我先给你一个简单的答案:学大模型不仅仅是做题、读文献那么简单,它关乎的是思维方式的转变,是对技术本质的深入理解。“大模型入门的路很长,你敢走吗?”首先,我得坦白说,大模型的学习不适合所有人,尤其是对于那些基础薄弱、没有相关项目